
CASE STUDY 03 / 05
Local-first AI Agent Workspace
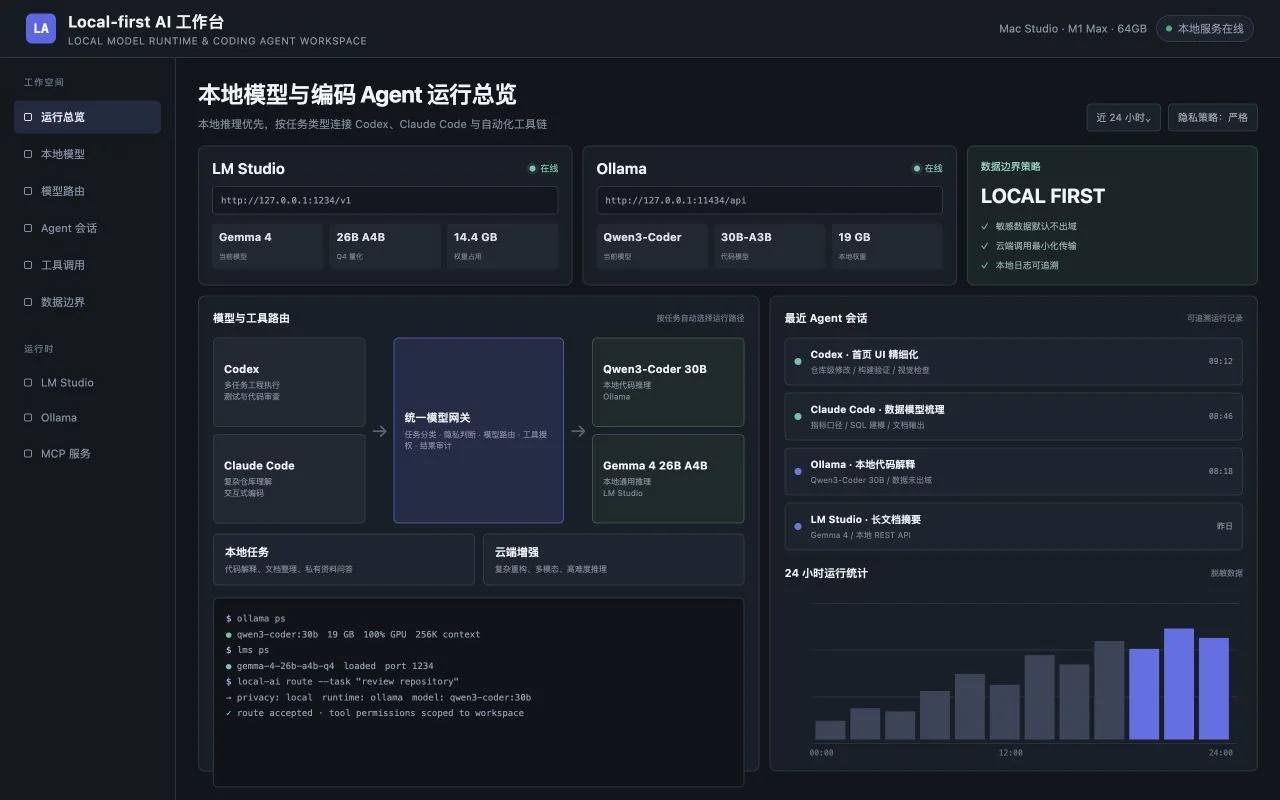
以本地优先为原则搭建的 AI Agent 工作空间,把本地大模型、工具编排与自动化任务整合为可日常使用、数据不出域的工程环境。
从经营问题、指标口径到数据模型与决策界面,聚焦系统如何形成长期可复用的分析能力。
01 Evidence
公开结论,也公开核验方式与证据边界。
- 数据边界
- 默认外发 → 默认本地
- 模型使用
- 单一路径 → 分层路由
- 工具依赖
- 单一服务 → 可替换编排
常规任务优先由本地运行时完成,敏感数据默认不出域。
根据数据敏感度与任务难度选择本地或云端能力。
模型、运行时与工具通过网关解耦,避免工作流锁定。
02 Case Narrative
问题、判断与工程落地。
01 / Problem
核心问题
云端 AI 工具虽然强大,但在隐私、稳定性与可控性上有天然约束;把敏感数据交给外部服务,并不总是可接受的选择。
02 / Approach
解决路径
以本地模型为基础,结合可信的云端能力做分层调度,把可本地完成的任务留在本地,把确需强模型的任务谨慎外发,形成隐私与能力的平衡。
03 / Architecture
系统结构
本地模型运行时(Ollama / LM Studio)提供基础推理,网关层统一编排工具与模型,Agent 层负责任务分解与执行,敏感数据默认不出域。
03 Decision Record
把取舍写清楚,比展示结果更重要。
- 当时的约束
- 敏感数据不能默认外发;本地模型在能力和速度上存在差异,云端强模型仍有价值,同时工具链必须保持可替换。
- 备选方案
-
- 01 全部使用云端模型
- 02 完全离线且拒绝所有云端能力
- 03 按数据边界与任务难度进行分层路由
- 为什么这样选
- 选择 Local-first 分层架构:本地运行时承担常规推理,网关统一模型与工具路由,只有必要任务在最小化数据后外发。
- 我的具体贡献
- 独立完成模型选型、运行时配置、路由规则、工具编排、Agent 工作流和失败恢复策略,并持续用真实任务校准边界。
- 结果与复用价值
- 日常任务默认在本地完成,同时保留复杂任务调用强模型的能力;模型与工具可以替换,不把工作流锁定在单一服务上。
- 公开证据边界
- 公开画面依据实际使用的工具链重新绘制,不包含本机路径、账号、对话、文档内容或任何私人数据。
项目背景
我一直相信,AI 工具的价值不该以牺牲隐私和可控性为代价。云端模型能力强,但把所有数据都交给外部服务,在很多场景下并不合适。于是我给自己设了一个目标:搭一套本地优先的 AI 工作空间——尽可能多的任务在本地完成,只有确需强模型时才谨慎外发。
架构思路
整套环境分为几层:
- 本地模型运行时:用 Ollama 与 LM Studio 运行开源模型,承担大部分日常推理。
- 网关与编排层:统一管理工具调用与模型路由,决定一个任务是本地跑还是外发。
- Agent 层:负责把任务分解成可执行的步骤,并驱动工具完成。
- 数据边界:敏感数据默认不出域,外发前有明确的判断与最小化处理。
经验与反思
本地优先不是”拒绝云端”,而是把选择权拿回自己手里。哪些数据可以走云、哪些必须留在本地,应该是一个清醒的工程决策,而不是默认全部上传。
这套工作空间还在持续演进,但它已经改变了我对 AI 工具的使用方式:先问”这件事能不能在本地做好”,再考虑其他。
05 Impact
被留下来的,不只是一张看板。
-
让日常 AI 任务可在本地完成,数据默认不出域
-
在隐私与模型能力之间取得可控平衡
-
沉淀出稳定、可复用的本地 Agent 工作流
-
降低对单一云端服务的依赖
Next Case
AI 工具工程化评测体系