
01 Data Engineering
数据工程
从采集、建模到治理,建立稳定、可复用的数据链路。
- 数据建模与仓库分层
- 批流一体管道(Spark / Flink)
- 数据质量与指标口径治理
- SQL 性能优化
About
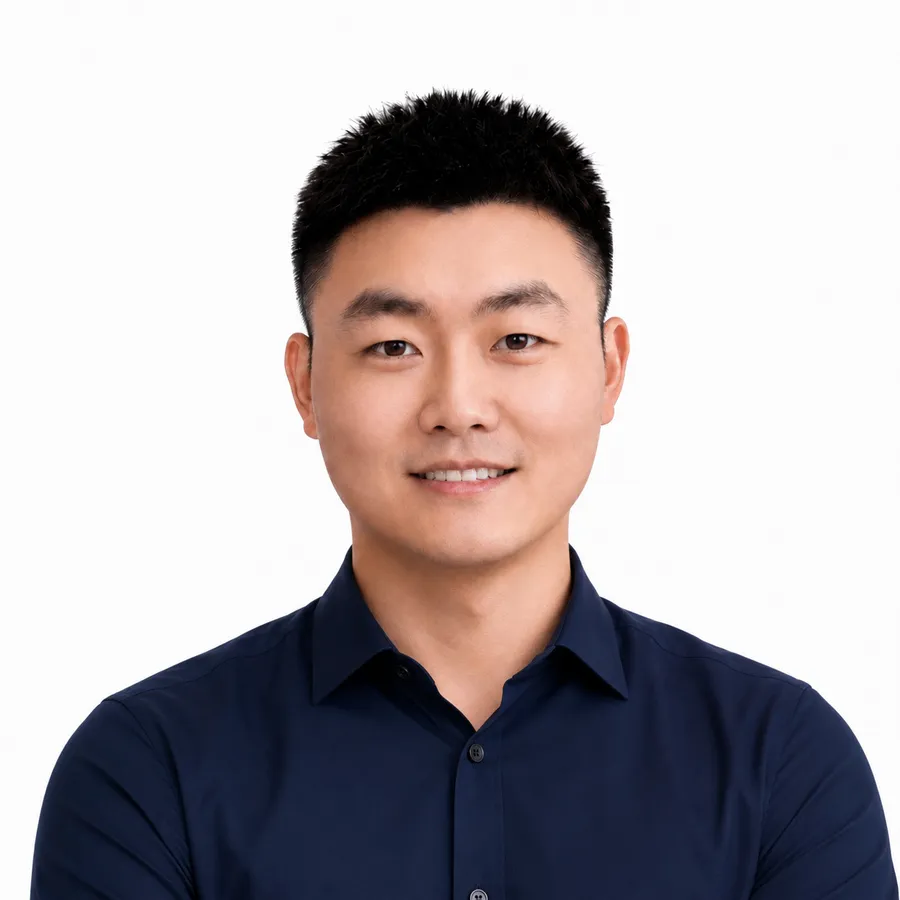
我在数字化转型与 AI 工程之间工作:定义问题、整理数据、构建系统,也持续校准自己的判断。
01 Introduction
我目前从事企业数字化转型工作,日常围绕数据工程、合同盈利分析、经营分析与数据治理展开,同时把 AI Agent、本地大模型与自动化工作流引入真实业务。
我的工作通常从一个模糊的经营问题开始:先统一语言与口径,再建立数据结构和工程边界,最后把结果交付为能够持续使用的系统。
相比一次性的演示效果,我更在意长期稳定、证据边界与可维护性。审美上保持克制,因为真正复杂的部分应该留在系统内部。
02 Principles
先定义业务问题与判断边界,再讨论技术选型。
让结论建立在数据与事实之上,警惕直觉和话术。
重要数据尽量不出域,优先可私有化、可离线的方案。
偏爱结构清楚、可测试、能长期维护的系统。
把复杂留在系统内部,把简单交给使用者。
工具服务于目标,不让热点替代判断。
03 Practice
从数据底座、经营分析到 AI 工程与组织落地,工作围绕同一条交付链路展开。
从采集、建模到治理,建立稳定、可复用的数据链路。
让数据服务于决策,构建合同级、经营级的分析体系。
把大模型能力工程化,落到真实业务与工作流之中。
在本地与私有环境部署模型与工具,兼顾隐私与稳定。
用自动化消除重复劳动,沉淀可复用的工程实践。
从业务问题出发,推动组织的数据与智能化落地。
04 Uses
设备、模型与软件会持续变化;选择标准保持稳定:本地优先、可控、可复用、能够进入真实工作流。
05 Now
AI Agent 的工程化与长期可用性
本地大模型在真实业务中的落地
合同盈利与经营分析的数据体系
把重复劳动交给自动化工作流
Engineering Intelligence. Designing Life.
Contact · Shanghai / Remote
适合讨论经营分析、数据治理与 Local-first AI。先确认真实问题、约束和判断边界,再决定是否需要系统建设。