
CASE STUDY 04 / 05
AI 工具工程化评测体系
一套可复用的 AI 工具与模型评测方法,用工程化、可复现的方式判断工具的真实价值,而非停留在营销话术与主观体感。
从经营问题、指标口径到数据模型与决策界面,聚焦系统如何形成长期可复用的分析能力。
01 Evidence
公开结论,也公开核验方式与证据边界。
- 选择依据
- 主观体感 → 固定用例
- 记录方式
- 零散结论 → 版本化证据
- 失败边界
- 隐性问题 → 显式记录
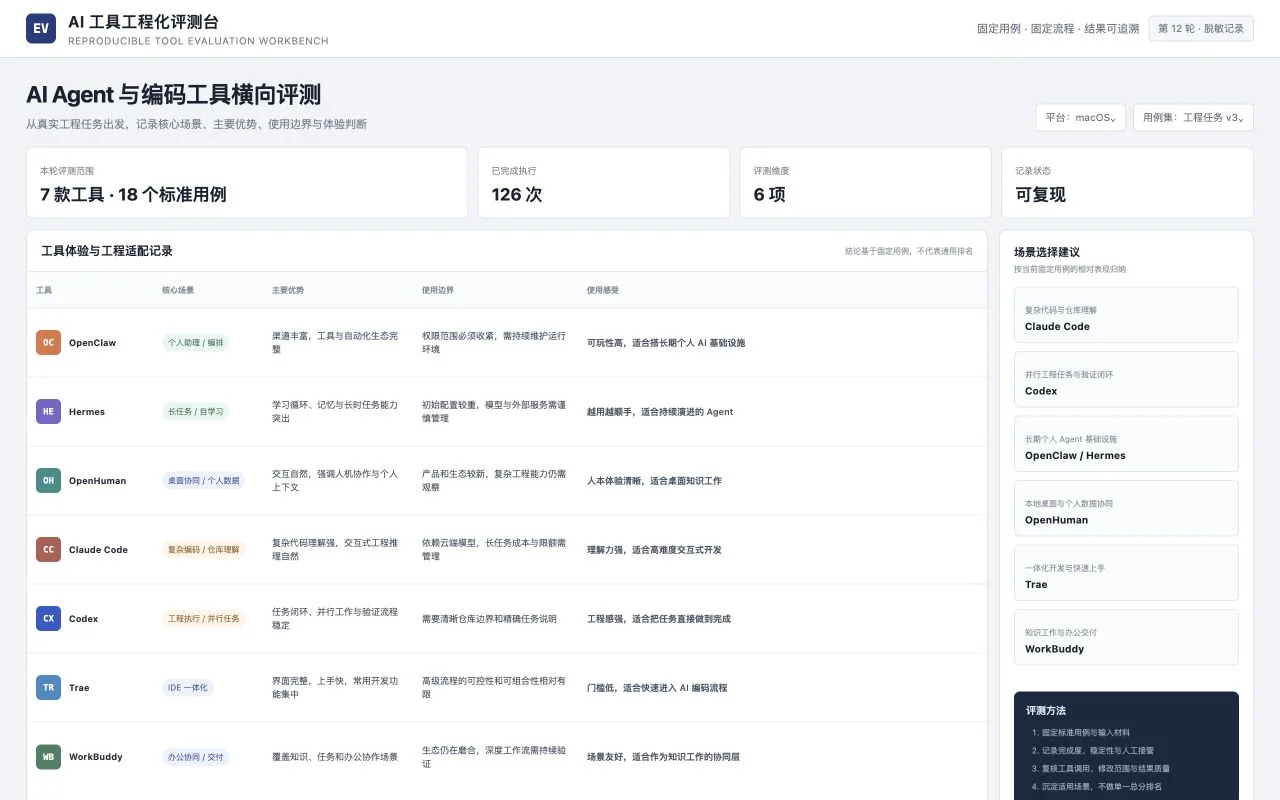
同一任务、同一维度和同一记录结构下比较不同工具。
保留每次评测的过程、结论与版本变化,支持复核。
不只记录成功演示,也记录稳定性、集成成本与不适用场景。
02 Case Narrative
问题、判断与工程落地。
01 / Problem
核心问题
AI 工具迭代极快、宣传夸张,"能用"和"好用"之间差距很大。缺少一致的评测方法,就容易被话术带节奏,把时间浪费在不合适的工具上。
02 / Approach
解决路径
从真实工作场景出发抽象出评测维度与标准用例,用可复现的方式横向对比,让"选型"建立在证据之上,而不是体感与热度。
03 / Architecture
系统结构
评测框架包含用例集、评分维度与记录模板;每次评测固定流程、固定用例,保证结果可比、可追溯。
03 Decision Record
把取舍写清楚,比展示结果更重要。
- 当时的约束
- 工具更新快、营销噪声大;个人体感难以复现,公开榜单也无法代表真实工程任务中的稳定性与集成成本。
- 备选方案
-
- 01 跟随热度与口碑选型
- 02 只比较公开榜单
- 03 用固定场景、维度与记录模板持续评测
- 为什么这样选
- 选择以真实工作任务建立标准用例集,固定流程和评分维度,每次只改变被测工具,并同时记录失败边界与适用场景。
- 我的具体贡献
- 设计评测方法、用例、记录模板与比较维度,持续执行测试并区分可公开的观察、个人判断和尚未验证的结论。
- 结果与复用价值
- 将“好不好用”转化为可比较、可追溯的选择过程,更快排除不适合当前工作流的工具,并保留版本变化记录。
- 公开证据边界
- 公开画面是基于实际使用维度的脱敏重构;展示评分仅用于说明界面结构,不作为正式排行榜或第三方性能声明。
项目背景
AI 工具的更新速度远超一般软件,宣传又往往夸张。“演示很惊艳、上手就翻车”是常态。如果没有一致的评测方法,选型就很容易被话术带着走。
我想要的,是一套工程化、可复现的评测方式:同样的用例、同样的维度、同样的流程,让不同工具在同一把尺子下比较。
评测框架
框架由三部分组成:
- 标准用例集:从真实工作场景中抽象出的代表性任务,覆盖工具最常被使用的能力。
- 评分维度:把”好用”拆解成可判断的维度,例如稳定性、可控性、工程集成度等。
- 记录模板:固定的记录方式,让每次评测都可追溯、可对比。
关键是固定变量:每次只让工具本身变化,流程和用例保持一致,结果才有可比性。
经验与反思
做评测的过程,也是在训练自己不被热度左右的判断力。很多工具在演示里很惊艳,但一旦放进真实、重复的工作流里,边界很快就暴露出来。
证据驱动的选型不一定总能选到”最热”的工具,但更容易选到”最合适”的那个。
05 Impact
被留下来的,不只是一张看板。
-
用可复现的方法替代主观体感做工具选型
-
沉淀出可持续更新的评测用例与标准
-
更快识别工具的真实边界与适用场景
-
减少在不合适工具上的时间浪费
Next Case
内容生产自动化工作流